Xで「Jev」っていう新しいAIの名前を見かけたんだけど、ChatGPTと何が違うの?文章を書いてくれるわけじゃないって聞いたし、無料で今すぐ試せるのかも分からない。エンジニアじゃない自分にも関係あるのかな…。
といった悩みにお答えします。
本記事の内容
- Jevとは?文章を作るAIではなく「判断する」AI
- System One Modelとは|会話するAIではなく中で判断するAI
- Jevでは何ができる?問い合わせの振り分けを例に見る
- Jevの3つの判断方法|Noul・Choice・Score
- JevとChatGPT・Claudeは何が違う?置き換えではなく組み合わせるAI
- Jevはなぜ高速で安いの?仕組みを初心者向けに解説
- Jevは本当にChatGPTより193.6倍速く444.6倍安い?
- Jevの料金はいくら?入力0.042ドルで出力は無料
- Jevは無料で使える?無料プラン・クレジット・Cloudflare経由を分けて整理
- Jevは今すぐ使える?waitlist・Web画面・APIの現状
- Jevの使い方|情報を渡して質問を定義し答えを受け取る5ステップ
- Jevの活用例|Claudeと組み合わせるワークフロー
- Jevのメリットとデメリット・注意点
- Jevは本当にハルシネーションしない?形式の保証と判断の正しさは別
- Jevはどんな人に向いている?向いていない使い方も正直に
- Jevについてよくある質問
本記事の信頼性
この記事を書いている僕はブログ歴7年。「AIに仕事を奪われる!?」という危機感を抱いて、AIを必死に学びAIを使ったライター業務やブログなどの副業で月10万円を達成。現在はClaude Codeで業務効率化や会社の仕組みを作って、AIを活用した事業を行っています。この経験をもとに、AIに関する情報やノウハウを発信しています。
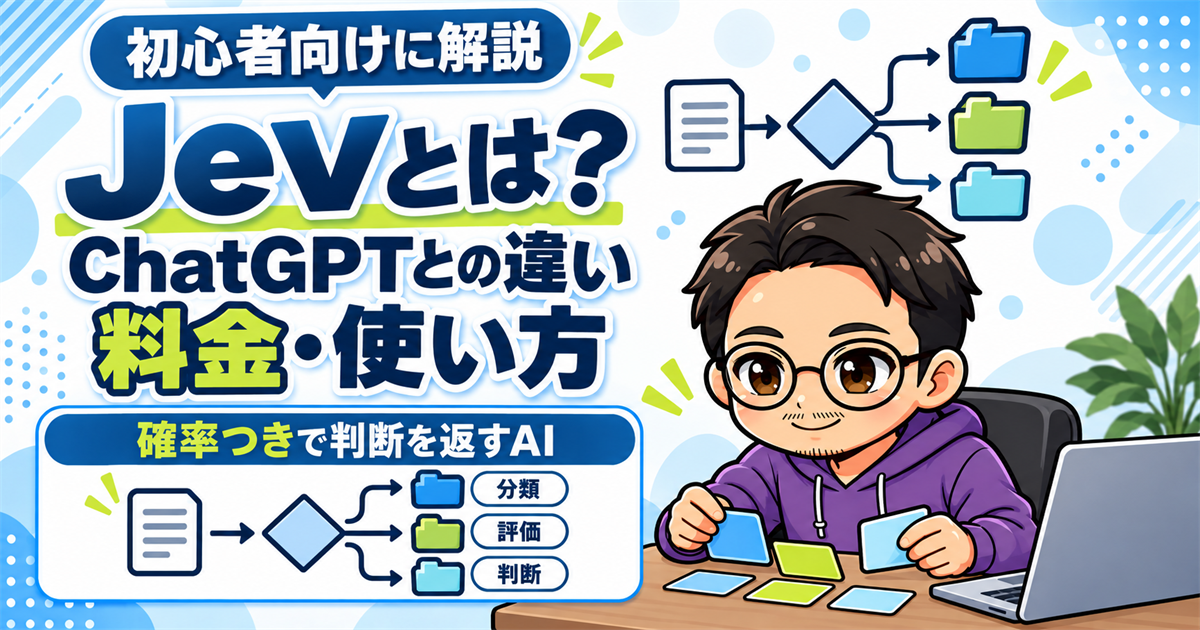
Jevとは、TypeSafe AIが2026年9月15日に発表した、文章を書く代わりに「分類・評価・判断」の答えを確率つきで返す新しい種類のAIです。
ChatGPTやClaudeが「文章やコードを生成するAI」なのに対して、Jevは「与えられた情報を読んで、用意された選択肢の中から判断するAI」で、ソフトウェアの中で使うことを前提に作られています。
料金は入力100万トークンあたり0.042ドルで出力は無料ですが、TypeSafe AIから直接使う場合はいまEarly Access(早期提供)の段階で、waitlistに登録した人から順番に案内されているんですよ。
読み終えると、Jevが「判断を返すAI」で、ChatGPTやClaudeと組み合わせて使うものだと分かり、自分が今すぐ試す側か様子を見る側かを決められます。
 りょうた
僕はClaude Codeでブログ運営を自動化していて、記事の分類やチェックみたいな「判断」の工程をLLMにやらせると、1本ごとに何秒も待ってお金もかかるのが気になっていました。だからJevの公式ドキュメントを最後まで読んで、何が本当で何がまだ分からないのかを整理しています。
Jevとは?文章を作るAIではなく「判断する」AI
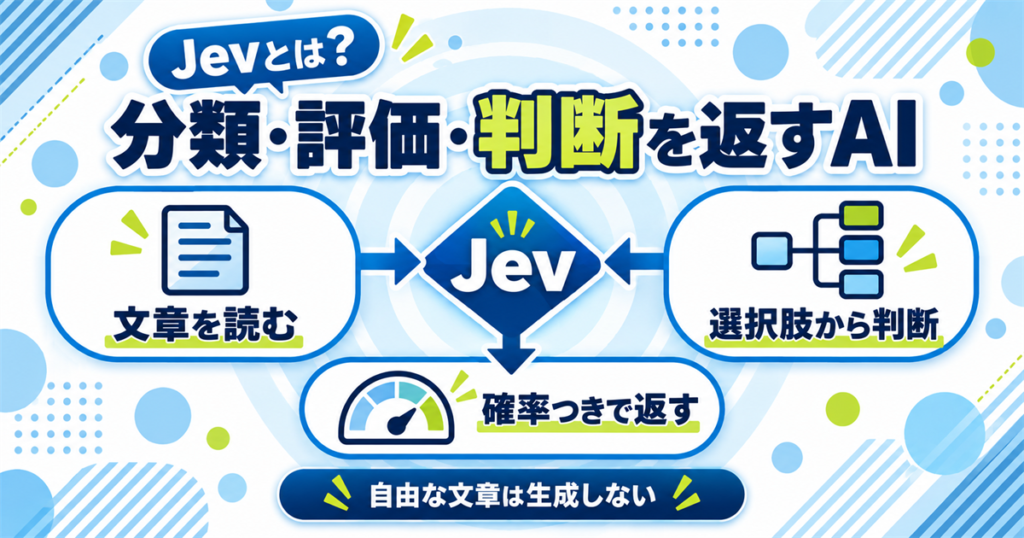
Jevとは、文章を生成する代わりに、与えられた情報を読んで「どれに当てはまるか」「どのくらい当てはまるか」を確率つきで返すAIです。
開発したのはサンフランシスコのTypeSafe AIで、公式は「System One Model」と呼ぶ新しい種類のAIの最初の公開モデルだと説明しています(TypeSafe AI公式サイト)。
まずは「ChatGPTと何が違うのか」を一言で押さえておきましょう。
ChatGPT・Claudeは「生成」でJevは「判断」を担う役割の違い
ChatGPTやClaudeが得意なのは、文章・コード・回答を生成することです。
一方でJevが得意なのは、与えられた情報をもとに分類・評価・判断をすることで、文章そのものは書きません。
役割のちがいを一言で
- ChatGPT・Claude … 「この問い合わせに返事を書いて」に答える
- Jev … 「この問い合わせは請求・技術・営業のどれ?」に確率つきで答える
つまり、あなたが普段チャットで使っているAIとは、そもそも仕事の中身が違うんですね。
公式FAQも「Jevは小さくもなくLLMでもない」「言語は理解するが自由な文章は生成せず、チャットボットとしては機能しない」と明言しています(TypeSafe AI公式FAQ)。
TypeSafe AIが2026年9月15日に発表した初のSystem One Model
Jevは、TypeSafe AIが2026年9月15日の公式ブログで発表しました(TypeSafe AI公式ブログ「Introducing System One Models & Jev」)。
創業者でCEOのDiogo Almeida氏について、TypeSafe AI公式は「ChatGPTのもとになった学習方法RLHFとInstructGPTの共同発明者で、元OpenAI・元Google Brain」と紹介しています(TypeSafe AI公式Teamページ)。
そのAlmeida氏が2年間ステルスで開発したのが、TypeSafe初のSystem One ModelであるJevなんです。
「チャットは何年も前から人間より上手なのに、自動化はどこに行ったのか」の一文が出発点だと、ブログの冒頭に書かれていますよ。
現在はEarly Accessで順番待ちの段階
TypeSafe AIから直接使う場合、Jevは2026年9月19日時点でEarly Access(早期提供)で、公式ブログは「waitlistに登録した開発者から、できるだけ早く順番に案内していく」と説明しています(TypeSafe AI公式ブログ)。
一般公開日は公式に発表されていないので、現在は順番待ちの段階で、「誰でも今すぐ使える」とは言えない状態ですね。
一方で、Cloudflare Workers AIとVercel AI Gatewayでは開発者向けにJevが提供されていて、こちらは各サービスの手順で呼べます(「今すぐ使える?」の章で整理します)。
とはいえ、公式ドキュメントも料金も評価データもすべて公開されているので、仕組みを理解するのに困ることはありません。
りょうた公式サイトを最初に開いたとき、僕はチャット画面を探してしまいました。でも「送るのは文章、返ってくるのは選択肢と確率」と分かった瞬間に、これはブログの記事チェック工程に置く部品だなと腑に落ちたんです。
System One Modelとは|会話するAIではなく中で判断するAI
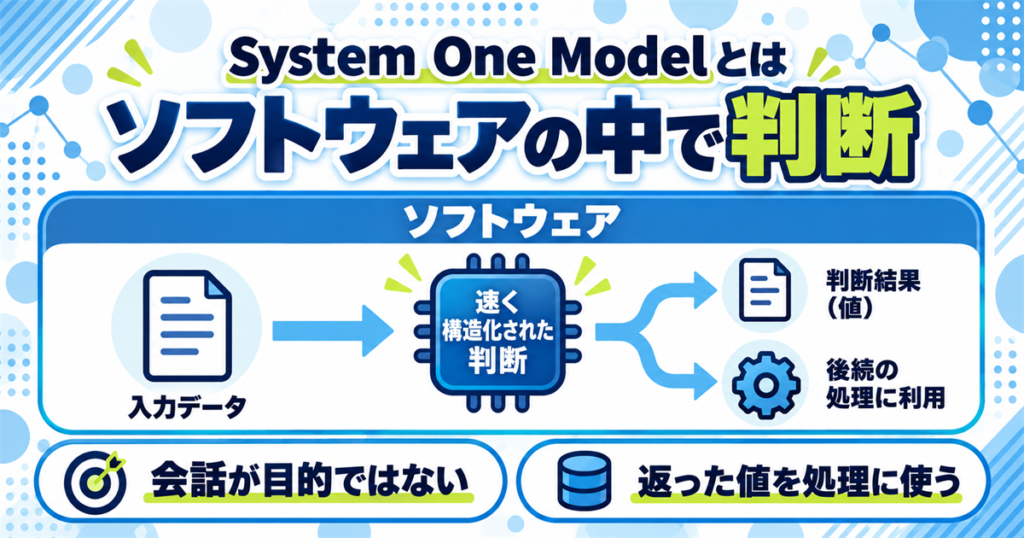
System One Modelとは、人間と会話するためのAIではなく、ソフトウェアの中で素早く判断を下すために作られたAIの種類です。
公式ドキュメントは「System One modelsは、ソフトウェアがそのまま使える速く構造化された判断を返すために作られたモデルの一種」と定義しています(TypeSafe AI公式ドキュメント「System One」)。
名前の由来を知ると、あなたもこのAIの性格がすっと分かるはずです。
カーネマンの「速い思考」から名付けられた
System Oneという名前は、心理学者ダニエル・カーネマンの著書『ファスト&スロー』に出てくる「システム1」から来ています。
カーネマンは人間の思考を、速くて直感的なシステム1と、遅くて熟慮するシステム2に分けました。
TypeSafeは公式ブログのFAQで、この区別にならって「速く集中した判断」を担うモデルをSystem Oneと名付けたと説明しています(TypeSafe AI公式ブログ FAQ)。
ただし公式は「システム1の思考は間違いやすいという意味も含んできたが、System One Modelはむしろ信頼性を高められると考えている」とも書いているので、直感=雑、ではありません。
Jevの名前は経済学者ジェヴォンズに由来する
Jevの名前は、19世紀のイギリスの経済学者ウィリアム・スタンレー・ジェヴォンズに由来します。
公式ブログは「蒸気機関の効率化のあとに石炭の需要が増えたのと同じ道を機械の知能もたどる」と見て、知能のコストが1桁下がるごとに使い道が桁違いに増えると見込み、この名前を選んだと説明しています(TypeSafe AI公式ブログ FAQ)。
つまり「安くて速い判断」を大量に使える世界を最初から狙っている、と名前で宣言しているんですね。
りょうた名前の由来を読んで、僕は「安くなれば使い道が増える」の部分に一番うなずきました。ブログの記事チェックも、1回が安ければ全記事に回せるので、まさにジェヴォンズの話そのものなんです。
Jevでは何ができる?問い合わせの振り分けを例に見る
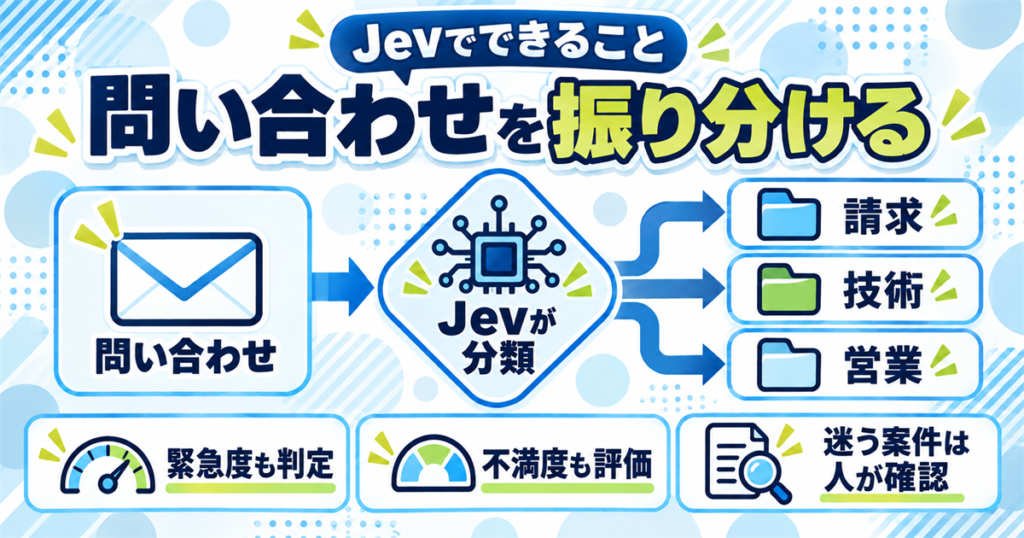
Jevでできるのは、問い合わせの分類・優先度の判定・リスク評価・スコアリング・コンテンツの判定・ワークフローの分岐・人の確認が要るかどうかの判定です。
抽象的に聞こえるので、公式のクイックスタートにある問い合わせの例で流れを追ってみましょう(TypeSafe AI公式ドキュメント「Quick start」)。
あなたの職場にも、毎日同じ基準で振り分けている作業はありませんか?
問い合わせが届いてから担当部署に届くまでの流れ
公式の例では、「3日前からStripeの接続に失敗していて売上を失っている、至急助けてほしい」と書かれた顧客の文章をJevに渡します。
- 問い合わせの文章をJevに送る
- Jevが内容を読んで「請求」「技術」「営業」のどれかを判断する
- 「請求 0.84・技術 0.159・営業 0.001」のように各選択肢の確率が返る
- ソフトウェアが確率の高い「請求」の担当へ自動で送る
同じ1回の送信で「緊急か」(0.999)と「顧客の怒り具合」(3段階の1.035)も一緒に返ってくるので、優先度の判定まで一度に済みます。
しかも公式ドキュメントによれば、確率が低くて迷う案件だけを人に回す分岐も、コード側で決められるんです(TypeSafe AI公式ドキュメント「Confidence」)。
公式ドキュメントが挙げる7つの使いどころ
公式の用途マップは、判断の形ごとに使いどころを整理しています(TypeSafe AI公式ドキュメント「Example use cases」)。
| 判断の形 | どんなときに使うか | 例 |
|---|---|---|
| 分類 | 決まったカテゴリのどれか1つに入れたい | 問い合わせの部署・文書の種類 |
| 検出 | ある性質が含まれる確率を知りたい | スパム・不正・緊急度・ジェイルブレイク |
| スコアリング | 段階のどこに当たるかを知りたい | 深刻度・品質・不満度 |
| ルーティング | 判断の結果で次の処理を選びたい | エスカレーション・モデルの切り替え |
| 検索・ランキング | 質問に合うものを探して並べたい | 文書の検索・候補の優先順位 |
| 検証 | 別のAIの出力に誤りがないか確かめたい | 引用の裏取り・ツール呼び出しの誤り |
| データ抽出 | 決まった項目を文章から取り出したい | 注文の項目・候補者の属性 |
※2026年9月19日時点の公式ドキュメントをもとに要約。
この表を見ると、Jevの仕事は「文章を作る」ではなく「文章を読んで仕分ける」に集中していると分かりますよね。
りょうた僕のブログ運営で言えば、「この下書きは公開基準を満たすか」「どのカテゴリに入れるか」の判定がまさにこの表の仕事です。毎回LLMに長い文章を書かせて判定していたので、確率だけ返してくれる部品があるのは魅力に映りました。
Jevの3つの判断方法|Noul・Choice・Score
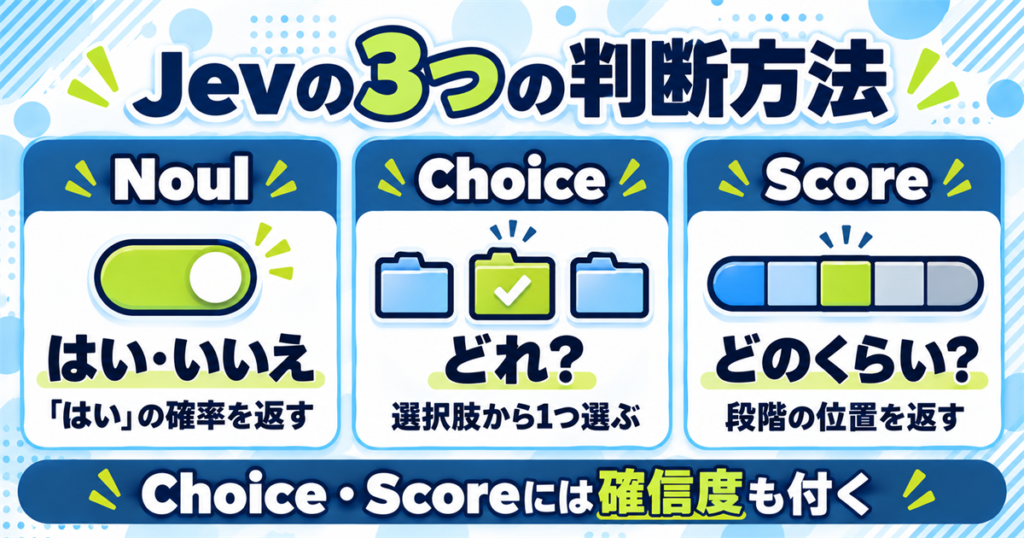
Jevの判断方法は、Noul・Choice・Scoreの3つです。
どれも「1つの判断」を聞く形で、リクエストのトークン上限の範囲なら、3種類を混ぜた複数の質問を1回の送信にまとめられます(TypeSafe AI公式ドキュメント「Primitives」)。
あなたが人に質問するときの「はい・いいえ」「どれ」「どのくらい」の3パターンだと思えば覚えやすいですよ。
| 質問の種類 | 聞き方の例 | 返ってくるもの |
|---|---|---|
| Noul | この問い合わせは緊急ですか | 「はい」である確率(0〜1) |
| Choice | この問い合わせはどの部署ですか(営業/請求/技術) | 選ばれた選択肢+各選択肢の確率+confidence |
| Score | この問い合わせの緊急度は(低い/普通/高い) | 段階の位置を示す数値+各段階の確率+confidence |
※公式ドキュメント「Primitives」の説明をもとに作成。
Noulは「はい・いいえ」を確率で答える
Noulは「この文章は返金を求めていますか」のような、はい・いいえで答えられる質問に使います。
返ってくるのは「はい」である確率で、1に近いほど強い「はい」、0に近いほど強い「いいえ」、0.5付近は判断がつかない状態です。
なので「0.95なら自動で返金の窓口へ、0.5前後なら人が読む」といった線引きを、あなたのソフトウェア側で決められるんですね。
Choiceは用意した選択肢から1つを選ぶ
Choiceは「営業・請求・技術のどれ?」のように、順番のない選択肢から1つを選ばせる質問です。
答えには選ばれた選択肢だけでなく、全部の選択肢の確率とconfidence(確信度)が付いてきます。
公式ブログによれば選択肢は最大255個まで用意でき、一覧にない答えを勝手に作ることはありません(TypeSafe AI公式ブログ)。
ただし公式は「一覧が全部の入力をカバーできないなら『その他』の選択肢を足す」ことを勧めているので、選択肢の設計はあなたの仕事になります。
Scoreは段階を決めてどの位置かを答える
Scoreは「顧客の不満度は、落ち着いている/不満だが丁寧/とても怒っている、のどこか」のように、順番のある段階を決めて位置を答えさせる質問です。
段階は0・1・2のように番号で表され、答えは1.4のように段階の間の値になることもあります。
だからこそ「緊急度が1.5以上なら当日中に対応」のように、しきい値で分岐させる使い方と相性がいいんです。
答えについてくる「確率」と「confidence」の読み方
確率は「各選択肢がどれくらい当てはまるか」の分布で、confidenceは「その分布がどれだけ1つに集中しているか」を0〜1の1つの数字にまとめたものです(TypeSafe AI公式ドキュメント「Confidence」)。
公式が勧めるconfidenceの使い方(3段階)
- 高い … 自動で実行する
- 中くらい … 確認を挟んでから実行する
- 低い … 実行せず、人に回すか別のAIに聞く
どこで線を引くかは「間違えたときの損失の大きさ」で決めるよう公式は案内していて、送金の承認のような重い判断ほど高いしきい値にする例が載っています。
なお、Noulにはconfidenceが別に付かず、確率そのものを見て判断します。
りょうた僕が一番気に入ったのは「確率が低い案件だけ人が見る」の設計です。全部を人がチェックする前提を崩せるので、記事の公開前チェックを自動化したい人には刺さる考え方だと思います。
JevとChatGPT・Claudeは何が違う?置き換えではなく組み合わせるAI
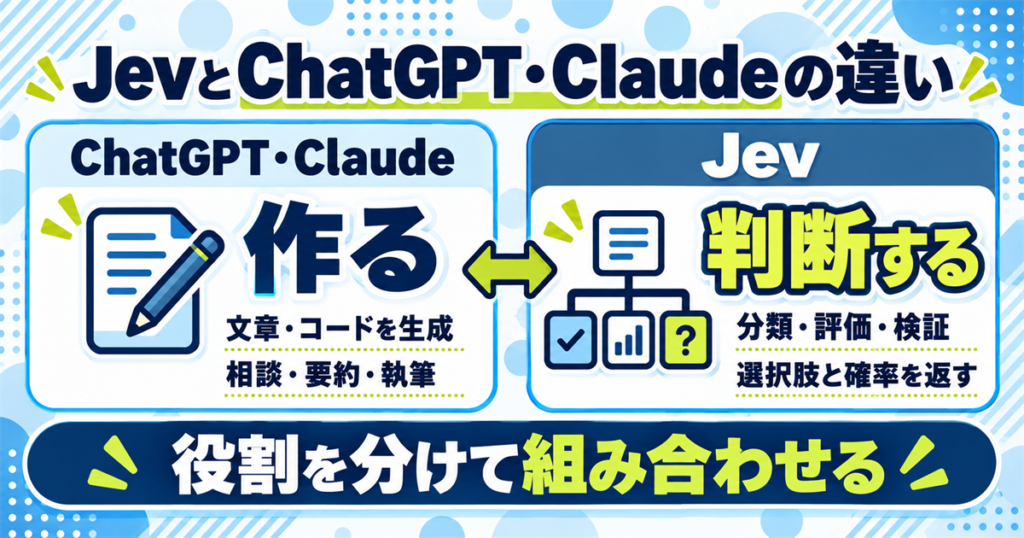
JevとChatGPT・Claudeの違いは、文章を生成するAIか、判断だけを返すAIかの「用途の違い」であって、優劣の話ではありません。
ここは検索している人が一番誤解しやすい部分なので、9つの項目で表にしてから理由を説明しますね。
あなたが「どちらか一方を選ぶ」必要はないことを、先に知っておいてください。
9項目で見る比較表
| 項目 | ChatGPT・Claude | Jev |
|---|---|---|
| 主な目的 | 人と会話し、文章やコードを作る | ソフトウェアの中で判断を返す |
| 出力 | 自由な文章 | 事前に決めた型の値(選択肢・段階・確率) |
| 文章生成 | 得意 | しない(公式が「生成用ではない」と明記) |
| 分類・判断 | できるが文章として返る | 本業。選択肢の中から確率つきで返す |
| 確率・confidence | 頼めば書くが数値の当たり具合は保証されない | すべての答えに付く。当たり具合を鍛える学習をしている |
| 処理方法 | 1トークンずつ順番に生成 | 全部の答えを1回で並列に出す |
| 自動化への組み込み | 文章を解析して値に直す工程が要る | 返ってきた値をそのまま分岐に使える |
| API | あり(チャット形式) | あり(stateと質問を送る形式) |
| 向いている用途 | 執筆・要約・相談・コーディング | 振り分け・判定・スコアリング・検証 |
※公式ブログの比較表と公式FAQをもとに作成(2026年9月19日確認・TypeSafe AI公式ブログ)。
公式FAQは、ChatGPTなどにあるJSONモードや構造化出力との違いも「文章生成モデルに型を強制するのではなく、最初から構造化された判断のために学習している点」だと説明しています(TypeSafe AI公式FAQ)。
ChatGPT・Claudeの代わりにはならない理由
Jevが代わりにならないのは、そもそも文章を1文字も書かないからです。
公式FAQも「複雑な数学やチェスのような計画など、長い推論が要る課題は大規模な推論モデルの方が向く」と認めています(TypeSafe AI公式FAQ)。
違いは、どちらが賢いかではなく「作る係」と「仕分ける係」のどちらを任せるか、にあるんですね。
Claude側で何ができるかは、Claudeの使い方|初心者が今日から仕事で使える7つの活用術で7つの場面に分けて解説しています。
りょうた「ChatGPTの上位互換が出た」と受け取ると、たぶん期待を外します。僕は「Claudeが書いたものをJevが採点する」組み合わせで初めて意味が出る部品だと理解しました。
Jevはなぜ高速で安いの?仕組みを初心者向けに解説
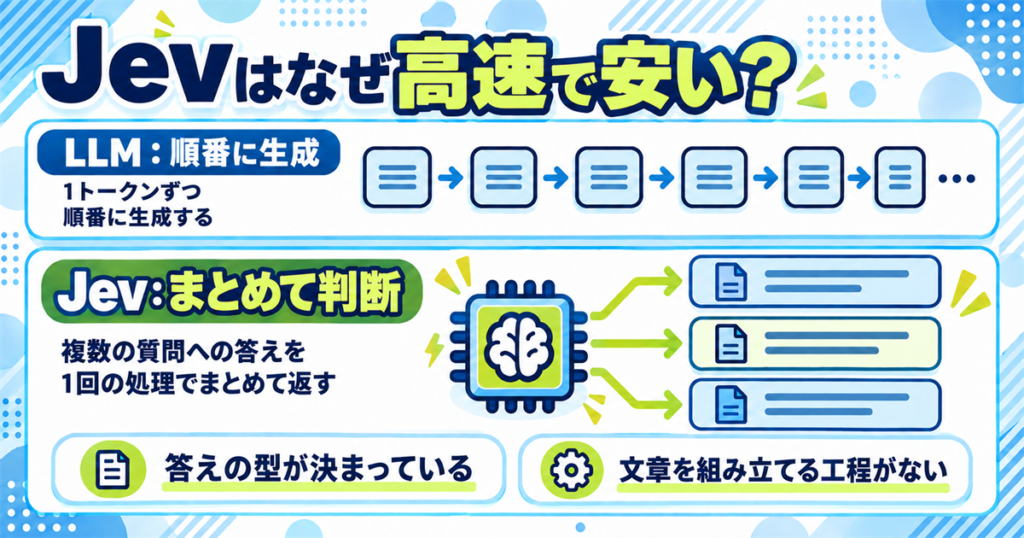
Jevが速くて安い理由は、文章を1トークンずつ書く工程をやめて、決まった型の答えをまとめて一度に出す仕組みにしたからです。
公式ブログの比較表では、フロンティアLLMの応答が3〜329秒なのに対し、Jevは70ミリ秒〜500ミリ秒とされています(TypeSafe AI公式ブログ)。
難しい言葉は最小限にして、「なぜ速いのか」に必要なところだけを見ていきましょう。
1文字ずつ書くLLMと一度にまとめて答えるJev
ChatGPTやClaudeのようなLLMは、次の1トークン(文字のかたまり)を予測しては付け足す作業を、答えが終わるまで繰り返します。
長い文章ほど繰り返しが増えるので、時間もお金もかかるわけです。
一方でJevは「並列サンプリング(parallel sampling)」と呼ぶ方式で、全部の質問に対する答えを1回の処理でまとめて出します(TypeSafe AI公式FAQ「How Can Jev Be So Fast And Inexpensive?」)。
そのため公式ドキュメントは「質問を増やしても応答時間はほとんど変わらない」と書いていて、これが速さと安さの土台になっているんですね。
答えの形が決まっているから無駄がない
もう1つの理由は、出力が「型の決まった構造化された値(typed structured outputs)」だからです。
選択肢・段階・確率の決まった形しか返さないので、文章を組み立てる工程も、返ってきた文章を解析して値に直す工程も要りません。
公式はこの性質を「型エラーを起こさない」と表現していて、実測ではなく設計上の保証だと明記しています(TypeSafe AI公式ブログ)。
Claudeの「じっくり考えてから答える」機能とは方向が逆なので、Claude拡張思考(Extended Thinking)の使い方と対比すると違いがはっきりします。
RLCDと呼ぶ学習方法で「確率の当たり具合」を鍛えている
Jevの学習方法は、TypeSafeが「RLCD(Reinforcement Learning for Calibrated Decisions)」と名付けた独自の手法です。
ChatGPTのもとになったRLHFが「人が好む文章」を目標にするのに対し、RLCDは「当たり具合が正しい確率つきの判断」を目標にします(TypeSafe AI公式ドキュメント「AI primer」)。
「較正された確率(calibrated probabilities)」の意味
- 確率0.8を付けた答えは、たくさん集めると約80%が実際に当たっている状態
- 確率0.2なら約20%が当たっている状態
- ただし公式は「多数の予測の集まりの性質で、1つ1つの答えの正しさを保証するものではない」と注記
要するに、Jevの速さは「文章を捨てて判断だけに絞った」設計から来ていて、RLCDはその判断に付く確率を信用できるものにする役目なんですね。
りょうた僕はここを読んで「速いのはズルではなく引き算だ」と納得しました。文章を書かない代わりに速いので、文章が欲しい場面では最初からJevを候補に入れない、と割り切れます。
Jevは本当にChatGPTより193.6倍速く444.6倍安い?
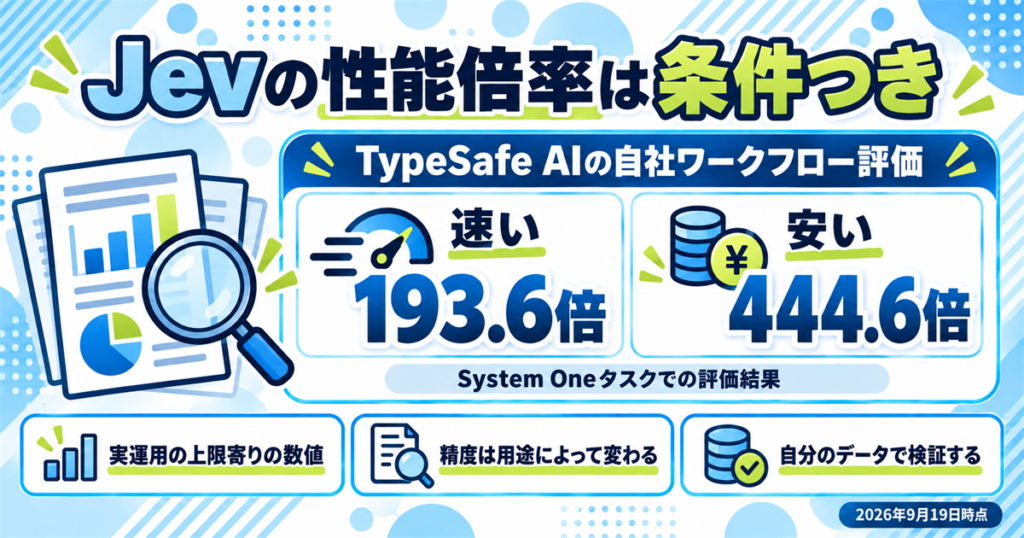
193.6倍速く444.6倍安いの数字は、TypeSafe AI自身が「System Oneタスクのワークフロー」で測った結果であって、ChatGPTのあらゆる使い方に当てはまる数字ではありません。
公式サイトのトップにはこの数字が大きく載っていますが、すぐ横に「*Based On Workflows For System One Tasks」の注記があります(TypeSafe AI公式サイト・2026年9月19日確認)。
あなたがこの数字をどう受け取ればよいかを、出どころ・公式の注意点・第三者の検証の順に整理します。
数値の出どころはTypeSafe AI自身のワークフロー評価
193.6倍・444.6倍の出どころは、公式ブログが「ワークフロー評価(Workflow evals)から来ている」と明かしている、TypeSafe自身の4つの業務ワークフローの結果です(TypeSafe AI公式ブログ)。
4つとは、セキュリティ警告の処理・エージェントの動作記録の確認・請求書の処理・カスタマーサービスで、正解は「GPT-6 AstraとClaude Fable 5.1(高い思考設定)の答えの平均」を基準にしています(TypeSafe Workflow evals)。
つまり「人間が付けた正解」ではなく「最上位モデル2つの平均」との一致率で精度を見ている点は、頭に置いておいてください。
公式サイトの「0.114秒 vs 8.566秒」「0.000081ドル vs 0.013880ドル」は別の数値
- この2組は、公式サイトが動画と一緒に載せているサイドバイサイドのデモ(問い合わせ1件を短い入力で判定させた比較)の数値
- 割り算すると約75倍・約171倍で、193.6倍・444.6倍の計算根拠ではない
- 公式ブログはこのデモを「入力が短くJevに有利」と注記している
公式が自分で書いている5つの注意点
意外に思うかもしれませんが、公式ブログはこの数字について自ら5つの注意点を書いています(TypeSafe AI公式ブログ「Nuance」)。
公式ブログの「Nuance」に書かれている注意点
- 193.6倍・444.6倍は「実運用で得られる効果の上限寄り」と見込んでいる
- 4つのワークフローは自社チームが作ったので、偏りがあり得る
- 正解の基準をAstraとFable 5.1の平均にしたため、OpenAI・Anthropicのモデルに有利な偏りがある
- 比較したLLM側は、TypeSafeの「構造化出力を強制するラッパー」経由なので、確率なしで答えさせるより遅く高くなりやすい
- サイドバイサイドのデモは短い入力なので、Jevに有利
さらに公式は、公開ベンチマークの成績を「意図的に公表していない」とFAQで述べ、利用者が自分の用途で評価を作るよう勧めています。
だからこそ、この倍率は「TypeSafeが自社評価で出した上限」として読むのが正しい姿勢なんですね。
第三者の検証で分かっていること
2026年9月19日時点で、第三者による検証は数件しか公開されていません。
| 検証した人(公開日) | 何を試したか | 速度 | 費用 | 精度 |
|---|---|---|---|---|
| TypeSafe AI(2026年9月15日・自社のワークフロー評価) | 業務ワークフロー4本 | 193.6倍速い(自社評価) | 444.6倍安い(自社評価) | 最上位2モデルの平均との一致率で比較 |
| TypeSafe AI(2026年9月15日・自社のデモ動画) | 問い合わせ1件を短い入力で判定 | 0.114秒 vs 8.566秒(約75倍) | 0.000081ドル vs 0.013880ドル(約171倍) | GPT-5.6 Terraとの不一致は1項目 |
| Every・Mike Taylor氏(9月15日) | 37本の文章に21問を同時に投げてAIっぽい書き癖を判定 | 1本0.35秒 vs Claude Fable 5.1 8.83秒(約25倍) | 推定で約580分の1 | 仕込んだ欠陥7つのうちJevは6つ・Fableは7つを検出 |
| クラスメソッド・DevelopersIO(9月17日) | 会話の難易度を4段階に分類(40回) | 中央値0.64〜0.67秒 | 1回約0.000026ドル | 40回すべて正解 |
| GitHubの公開ベンチマーク(9月17日) | フィッシングメール2,000通の判定 vs Claude Haiku 4.5 | 239ミリ秒 vs 687ミリ秒 | 1,000通あたり0.038ドル vs 0.462ドル | Jev 62.6% vs Haiku 81.3% |
※出典: Every/DevelopersIO/jev-phishing-bench。いずれも各実施者の条件での結果で、運営者は追試していません。
第三者の3件を並べると、速さと安さの方向は第三者でも確かめられている一方、精度はタスク次第で大きく変わることが分かります。
とくにフィッシング判定では、Jev単体の正答率が小型のClaude Haiku 4.5より約19ポイント低く、作者は「複数の質問に分けて組み合わせると差が縮む」と報告しています。
りょうた僕は「速い・安いは本当らしい、賢さは用途で試すしかない」と読みました。自分のブログのチェック項目で当ててみるまでは、倍率の数字だけで飛びつかないつもりです。
Jevの料金はいくら?入力0.042ドルで出力は無料
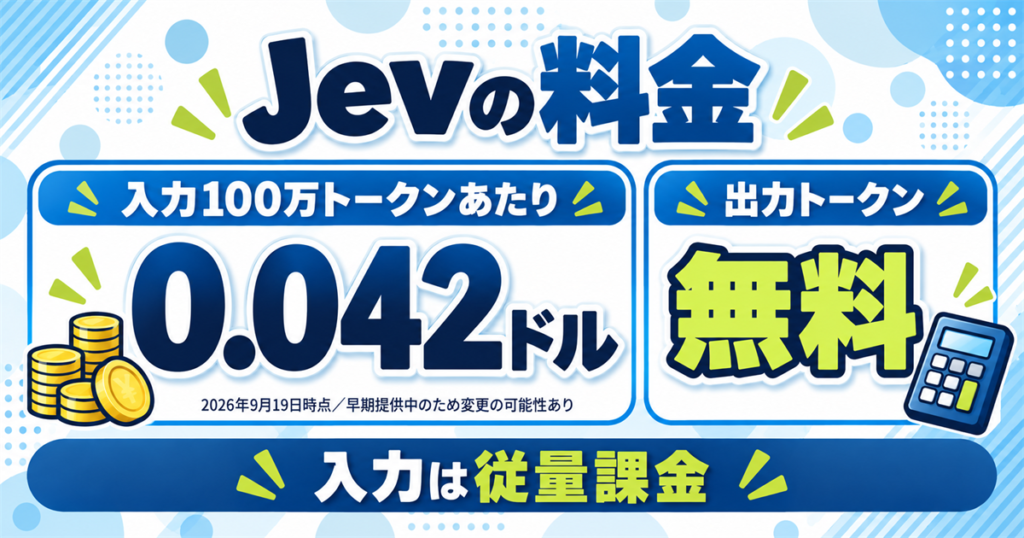
Jevの料金は、入力100万トークンあたり0.042ドルで、出力トークンは無料です(TypeSafe AI公式ドキュメント「Models」・2026年9月19日確認)。
公式サイトのトップでは同じ料金を「10億トークンあたり42ドル」と表記しているので、単位を見間違えないようにしてください。
あなたが円で感覚をつかめるように、換算の目安も出しておきますね。
入力100万トークン0.042ドルは10億トークンで42ドル
| 項目 | 公式の値 | 補足 |
|---|---|---|
| 入力トークン | 100万トークンあたり0.042ドル | 10億トークンあたり42ドルと同じ意味 |
| 出力トークン | 無料 | 公式ブログの表記は「FREE (too cheap to meter)」 |
| 現行モデル | jev-1.13.0 | jev-latestの名前で呼ぶと自動でこのバージョンになる |
※2026年9月19日時点の公式ドキュメント。Early Access中のため変更される場合があります。
トークンとはAIが文章を数える単位で、正確な数はモデルごとに違うので、公式の例(問い合わせ1件で312トークン)を目安にしてください。
公式ブログの比較表では、既存LLMの入力が100万トークンあたり0.20〜10ドルとされているので、その差が公式の言う「桁違いの安さ」の根拠になっています。
料金が一時的な赤字価格ではないかの疑問には、公式FAQが「現在の価格で利益を出して提供できる」と答えていますが、公式ブログでは「補助でないことは証明できない」とも書いているので、長期の持続性はこれから分かることですね。
日本円にするといくらか(為替で変動)
日本円に直すと、1ドル約157円(2026年9月18日の終値156.88円)で計算した場合、入力100万トークンは約6.6円です。
公式クイックスタートの問い合わせ判定の例は入力312トークンなので、1回あたり約0.002円、1万件を判定しても約21円になります。
ただし為替レートは日々変動するので、この金額はあくまで目安として見てください。
料金の比較先としてClaudeのプランを知りたい人は、Claudeの料金プランを比較|無料〜Pro〜Maxの選び方で個人向けの料金をまとめています。
レート制限と1回に送れる量
料金のほかに、送れる量の上限もあります。
公式ドキュメント「Models」の制限(2026年9月19日時点)
- レート制限 … 1秒あたり250,000トークン・1分あたり1,200リクエスト
- 1リクエストの上限 … 合計64,000トークン(情報+質問すべて)。情報+いちばん長い1問は32,000トークンまで
- 入力できるもの … テキストのみ(文字列・JSON・テキストの配列)。画像・音声・動画は非対応
公式は「需要が非常に多く、レート制限は予告なく変わる」と明記していて、しきい値を固定したい場合は「jev-1.13.0」のようにバージョン名を直接指定するよう勧めています(TypeSafe AI公式ドキュメント「Models」)。
りょうた僕が料金で見たのは単価より「出力が無料」の1行でした。判定させる仕事は答えが短いので、出力課金がない設計は用途とかみ合っているなと感じたんです。
Jevは無料で使える?無料プラン・クレジット・Cloudflare経由を分けて整理
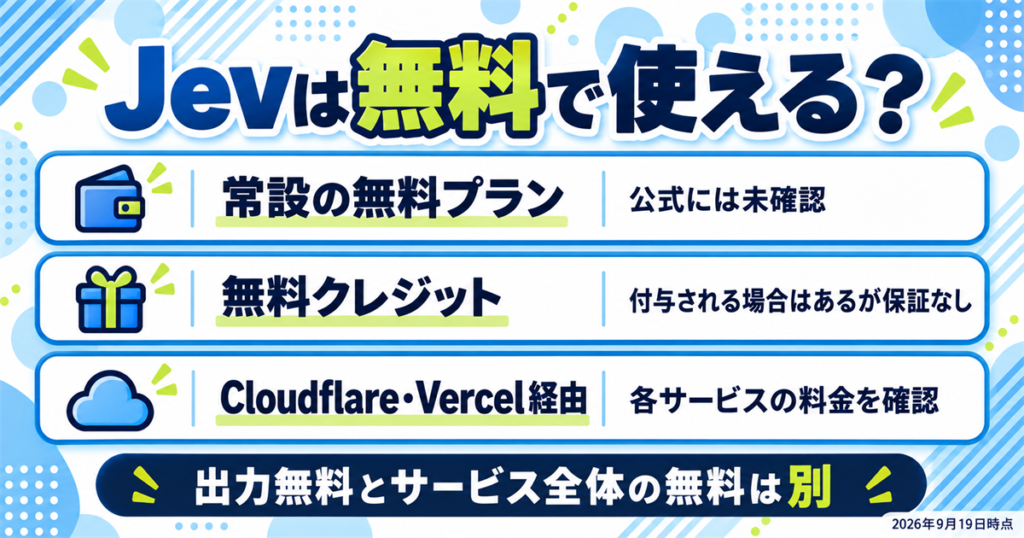
Jevが無料で使えるかは、2026年9月19日時点で常設の無料プランや全員に配られる無料クレジットは公式に確認できず、「無料で使える」とは言えません。
検索している人が混同しやすい5つの話を、一度ばらして整理しますね。
あなたが見た「無料」の一言が、どの箱の話なのかを確かめてください。
常設の無料プランと全員向けの無料クレジットは公式に確認できない
| 混同しやすい5つの話 | 公式に確認できること(2026年9月19日) |
|---|---|
| JevのAPI料金 | 入力100万トークン0.042ドル・出力無料の従量課金 |
| Early Access | waitlistから順番に案内。料金が無料になる意味ではない |
| 無料クレジット | 全員に配られる案内はなし。利用規約に「TypeSafeの裁量で無料のPromotional Creditsを付与する場合がある(義務はない)」の定めあり |
| Cloudflare・Vercel経由 | どちらでも提供中。料金は各サービスの案内に従う |
| 無料プラン | 公式に記載なし |
※出典: TypeSafe AI公式ドキュメント「Models」/TypeSafe Console/TypeSafe AI Master Customer Agreement 8.2。
料金ページに相当するのは公式ドキュメントのModelsページで、書かれているのは従量課金の単価だけです。
サインイン画面もGoogleアカウントかメールのコードで入る形で、無料枠や料金の説明は出てきません。
ただし利用規約(Master Customer Agreement)の8.2条には、支払いはクレジットを購入して消費する方式であることと、TypeSafeが自社の裁量で無料の「Promotional Credits」を付与する場合はあるが義務はないことが書かれています(TypeSafe AI Master Customer Agreement・2026年9月20日確認)。
つまり「無料クレジットの制度そのものは存在するが、誰にいくら配られるかは保証されていない」が正確な整理ですね。
Cloudflareの無料枠とJevが無料で使えることは別の話
Cloudflare Workers AIには1日10,000ニューロン(Cloudflare独自の計算単位)の無料枠がありますが、これはWorkers AI全体の話です(Cloudflare Workers AI Pricing)。
Jevのモデルページには「料金はCloudflareダッシュボードで確認」とあり、料金ドキュメントの一覧にtypesafe/jevの行はありません(Cloudflare AI docs「Jev」のモデルページ・2026年9月19日確認)。
要するに、Cloudflare経由でJevが無料になるとは公式に書かれていないので、使う前にダッシュボードの料金表示を見るのが確実です。
第三者の報告と公式の記載を分けて読む
利用者の公開記録の中には、コンソールに「free $5/month」の表示があったとの報告もあります(Zennのスクラップ「typesafe.ai の「Jev」を試す」)。
この表示は利用規約にあるPromotional Creditsに当たる可能性がありますが、付与の条件や継続性は公表されておらず、時期やアカウントで変わり得るため、この記事では「第三者の報告」として分けて扱います。
無料枠があるかどうかは、あなた自身がwaitlistを通ったあとにコンソールで確認するのがいちばん確実ですね。
りょうた「登録すると◯ドルもらえる」と書きたくなる誘惑はありましたが、規約に「配る場合がある」としか書かれていないものを「もらえる」とは書かないのがこのブログの方針です。無料枠の有無は変わりやすいので、記事より自分の画面を信じてください。
Jevは今すぐ使える?waitlist・Web画面・APIの現状
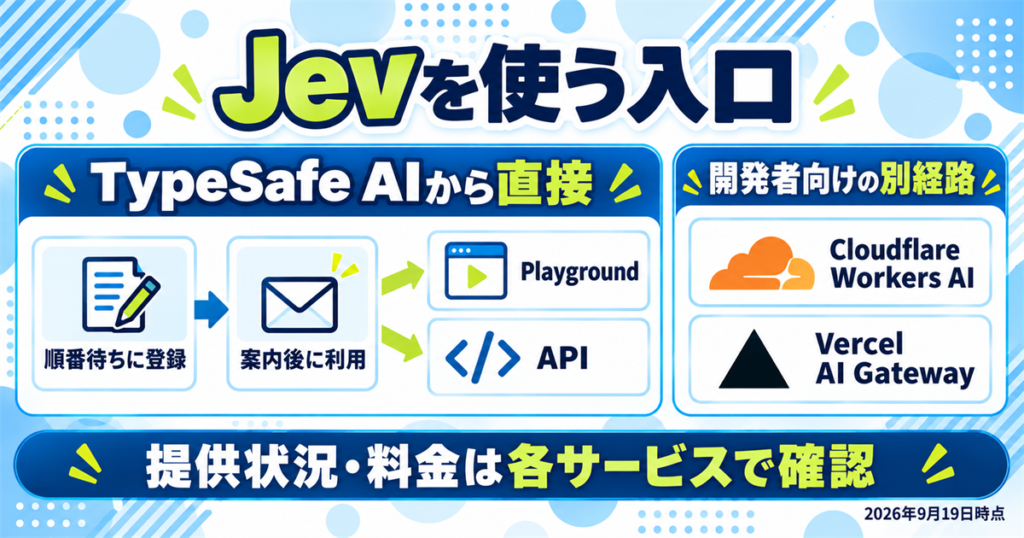
Jevを今すぐ使えるかは、TypeSafe AIから直接使う場合は2026年9月19日時点でEarly Accessのためwaitlistに登録して案内を待つ形で、別にCloudflareとVercel経由の入口があります。
「誰でも今すぐ」とは公式に書かれていない一方で、第三者の記録には登録後すぐ使えた例もあるので、状況は日々変わっています。
あなたが試したいなら、入口が3つあることを知っておくと動きやすいですよ。
TypeSafe AIのwaitlistに登録して順番を待つ
公式FAQの「始めるには?」の答えは「waitlistに登録して、Discordで質問や感想を共有してほしい」です(TypeSafe AI公式FAQ)。
公式ブログでも「開発者をwaitlistからできるだけ早く順番に案内する」と書かれているので、登録後は案内待ちになります。
ちなみにクラスメソッドの2026年9月17日の記事では、waitlist登録後すぐに使えたと報告されていますが、あなたのタイミングで同じとは限りません(DevelopersIO)。
ブラウザで試すPlaygroundとAPIの2つの入口
案内が届いたあとの入口は、ブラウザのWeb画面で試す「Playground」と、プログラムから呼ぶ「API」の2つです(TypeSafe AI公式ドキュメント「Quick start」)。
公式クイックスタートの2つの入口
- Playground … ログインして文章を貼り、質問を追加すると結果が画面に出る。チャット画面ではなく「質問と確率を確かめる画面」
- API … ダッシュボードでAPIキーを発行し、POSTリクエストを送る。Python SDK(typesafe-sdk)とJavaScript SDKもある
プログラミングをしない人でも、Playgroundなら「文章を貼って質問を書く」だけで動きを確かめられます。
Cloudflare Workers AIとVercel AI Gatewayでも提供されている
TypeSafeのアカウント以外に、Cloudflare Workers AIでは「typesafe/jev」として、Vercel AI Gatewayでは2026年9月16日から「typesafe-ai/jev」として提供されています(Cloudflare AI docs/Vercel Changelog)。
すでにどちらかのサービスを使っている開発者なら、そこからJevを呼べる形ですね。
ただしこの2つは開発者向けの経路なので、非エンジニアの人はまずTypeSafeのwaitlistとPlaygroundから入る方が分かりやすいです。
りょうた僕はwaitlistに並ぶ前に、公式ドキュメントのクイックスタートを読んで「自分の用途の質問文が書けるか」を先に考えました。入口より先に、何を判断させたいかを決めておく方が近道だと思います。
Jevの使い方|情報を渡して質問を定義し答えを受け取る5ステップ
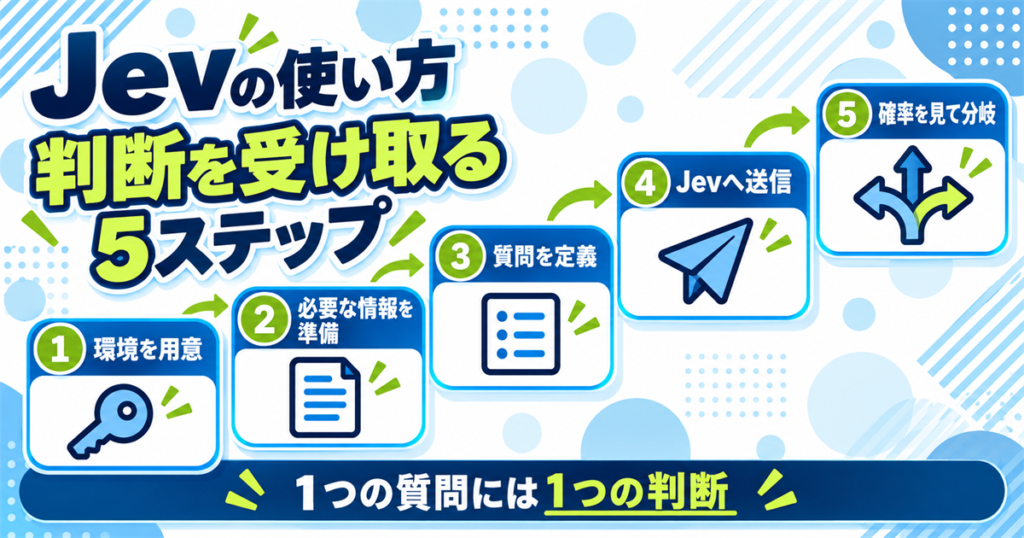
Jevの使い方は、判断してほしい情報(state)と質問(questions)を送り、答え・確率・confidenceを受け取ってコード側で分岐を決める流れです。
この記事は総合解説なのでコードの詳しい解説は省きますが、公式クイックスタートに沿って全体の流れを5ステップで示します(TypeSafe AI公式ドキュメント「Quick start」)。
あなたがエンジニアでなくても、「何を用意するのか」は掴めるはずですよ。
ステップ1:APIキーかPlaygroundなど使える環境を用意する
最初に、TypeSafeのアカウントでAPIキーを発行するか、ブラウザのPlaygroundを開きます。
プログラムから呼ぶ場合は、Python SDKなら「pip install typesafe-sdk」でインストールし、APIキーを環境変数に置くだけで準備は終わります(Python 3.10以上)。
Claude Codeなどのコーディングエージェント向けに、公式が「TypeSafeスキル」も配布しているので、エージェントに書かせる道もあります(TypeSafe AI公式ドキュメント「Agent skill」)。
Claude Codeをまだ入れていない人は、Claude Codeの3つの始め方を初心者向けに図解で分かりやすく解説から始めると迷いません。
ステップ2:判断してほしい情報(state)を用意する
stateは「判断の材料になる情報」で、問い合わせの文章・注文の記録・社内ルールなどをテキストかJSONで渡します。
公式は「質問に関係ない情報を詰め込むと精度が落ちる」と注意しているので、必要な部分だけを渡すのがコツです。
ステップ3:質問(Noul・Choice・Score)を定義する
次に、Noul・Choice・Scoreのどれかで質問を定義します。
「緊急か」(Noul)、「どの部署か」(Choice)、「不満度はどの段階か」(Score)のように、1つの質問には1つの判断だけを入れるのが公式の推奨です。
ステップ4:Jevに送信する
stateと質問をまとめて、APIに1回だけ送ると、質問が3つでも10個でも全部が並列に処理されます。
公式クイックスタートのcURL例を、質問1つの最小形にして引用します(TypeSafe AI公式ドキュメント「Quick start」・2026年9月19日確認)。
curl -X POST https://api.typesafe.ai/v1/systemone -H "Authorization: Bearer $TYPESAFE_API_KEY" -H "Content-Type: application/json" \
  -d '{"state": "Hi, I have been trying to connect my Stripe account for 3 days and it keeps failing. Please help ASAP.",
       "model": "jev-latest",
       "questions": {"urgency": {"type": "noul", "instructions": "Does this message express urgency?"}}}'
ステップ5:答え・確率・confidenceを受け取って分岐を決める
返ってくるのは、質問ごとの答えと確率、そしてChoiceとScoreにはconfidenceです。
公式の例では、部署は「請求」(確率0.84・confidence 0.596)、緊急度は0.999の値が返っています。
あとは「confidenceが0.9以上なら自動処理、0.5未満なら人に回す」のように、あなたのコードでしきい値を決めて分岐させれば、判断の自動化が1つ完成します。
りょうた5ステップの中で一番むずかしいのは、実は③の質問文だと感じました。「この記事は基準を満たすか」を1つの判断に割る作業は、人間の側の仕事なんですよね。
Jevの活用例|Claudeと組み合わせるワークフロー
Jevの活用例は、カスタマーサポート・AIエージェント・コンテンツ運営の3つを押さえると、自分の仕事に当てはめやすくなるんです。
公式ドキュメントの用途マップにある例をもとに、非エンジニアでもイメージできる形に直してみますね(TypeSafe AI公式ドキュメント「Example use cases」)。
あなたの職場の「毎日同じ基準で仕分けている作業」を思い浮かべながら読んでください。
カスタマーサポートで問い合わせを担当部署へ振り分ける
いちばん分かりやすいのが、カスタマーサポートで問い合わせの内容を読んで担当部署へ振り分ける使い方です。
公式のクイックスタートそのものがこの例で、部署の分類・緊急度・顧客の不満度を1回で判定します。
しかもconfidenceが低い問い合わせだけを人が読む運用にすれば、全件を目視する必要がなくなりますね。
AIエージェントに次の処理を選ばせる
AIエージェントの中で「次にどの処理を行うか」を選ぶ場面でも、Jevは公式が想定している用途です。
公式は「モデルの切り替え」「エスカレーション」「ツール呼び出しの誤りの検出」などをルーティングや検証の例として挙げています。
エージェントが何かを実行する前に「この操作は危険か」をNoulで確かめる、といったガードレールの使い方も公式のクックブックにあります(TypeSafe AI公式ドキュメント「Guardrails for LLMs」)。
エージェントの言葉になじみがない人は、Manus使い方完全ガイド【AIエージェントで作業を自動化する方法】で「AIが手順を自分で進める」感覚をつかんでおくと理解が早いです。
コンテンツ運営で大量の記事を同じ基準で分類する
コンテンツ運営では、大量の記事や投稿を一定の基準で分類・評価する場面に向いています。
公式の用途例にも「モデレーション」「品質や関連度のスコアリング」「文書の分類」が並んでいて、公式ブログは「大量データを特徴や知見に変える処理」を主要な用途の1つに挙げています。
ただし精度は用途で変わるので、自分の基準で小さく試してから広げるのが前提ですよ。
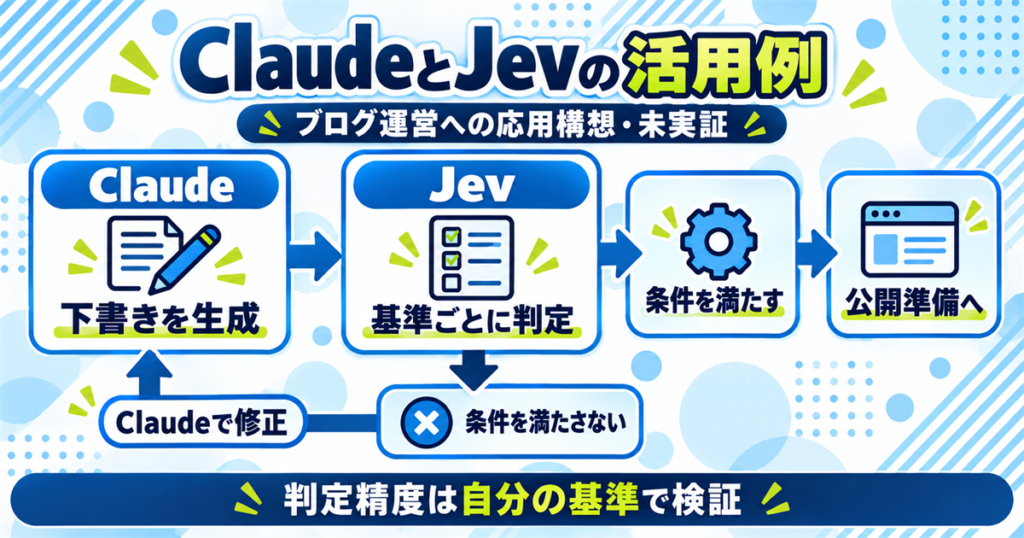
Claudeが作りJevが判定しClaudeが直す流れ(応用が考えられる例)
僕のブログ運営に当てはめると、次のようなワークフローへの応用が考えられます。
Claude→Jev→Claudeの流れ(構想であり未実証)
- Claude … 記事の下書きを生成する
- Jev … 「冒頭に結論があるか」「体験談が入っているか」など、基準ごとにNoulで判定する
- 条件を満たさない … 満たしていない項目だけをClaudeに戻して修正を頼む
- 条件を満たす … 公開準備の次の処理へ進める
これは「Claudeが作る係、Jevが仕分ける係」の役割分担で、記事1本ごとに長い評価文をLLMに書かせるより速く安くなる可能性があります。
ただし、JevがSEO記事の品質を正確に判定できると公式が示したわけではないので、あくまで応用が考えられる例として受け取ってください。
Claude Code側の自動化の組み方は、Claude Codeの使い方|仕事が変わる実践テクニック7選と効率化のコツで実例を紹介しています。
りょうた僕の運用では、記事チェックの項目が20個以上あって、毎回LLMに全部を文章で答えさせています。これをNoul 20問に置き換えたら1回の送信で済むのかと想像すると、試したくなるんですよね。
Jevのメリットとデメリット・注意点
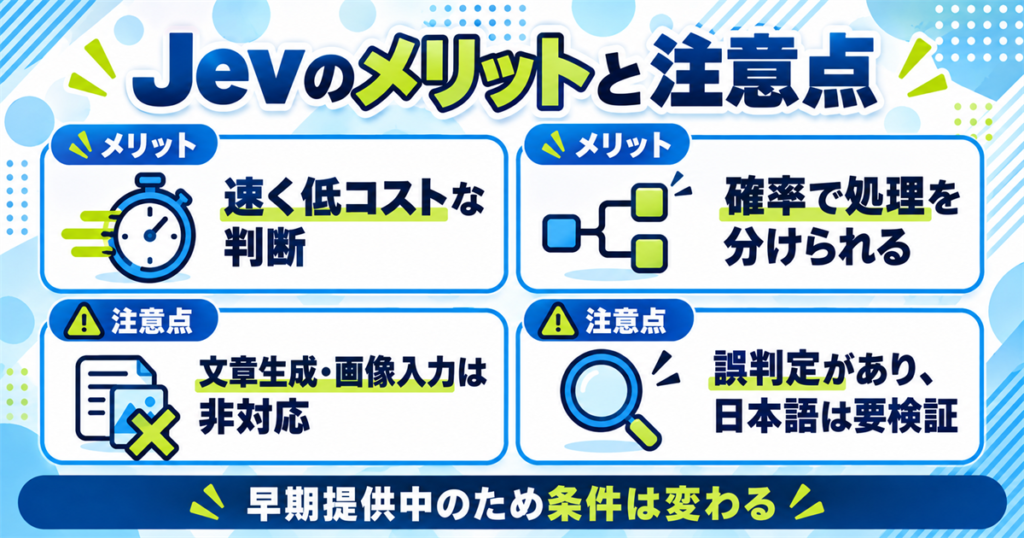
Jevのメリットは「判断が速く安い」「型が決まっていて組み込みやすい」「確率で人の確認が要る判断を分けられる」の3つで、デメリットは「文章生成が目的ではない」「判断は間違える」「Early Accessで第三者検証が少ない」の3つです。
どれも公式の記載を根拠に整理しているので、あなたが導入を考えるときの判断材料にしてください。
メリット1:判断が速く費用が小さい
公式ブログの比較表では応答が70ミリ秒〜500ミリ秒、料金は入力100万トークン0.042ドルで出力無料です(TypeSafe AI公式ブログ)。
公式のデモでは、ゲームのDoomを1秒に10回判断させ続けても費用は1時間あたり約7ドルだったと書かれています。
大量の判断を1件ずつ回す仕事ほど、この差が積み上がるわけですね。
メリット2:答えの形が決まっていてソフトウェアに組み込みやすい
2つ目のメリットは、返ってくるのが選択肢・段階・確率の決まった形なので、文章を解析する工程なしにソフトウェアの分岐にそのまま使えることです。
公式はこれを「型エラーを起こさない」と表現し、型の保証は設計上のものだと明記しているんですね。
メリット3:確率とconfidenceで人の確認が要る判断を分けられる
3つ目のメリットとして、すべての答えに確率が付き、ChoiceとScoreにはconfidenceも付くので、「自信がない判断だけ人が見る」運用を組めます。
公式ドキュメントも、confidenceの高低で「自動実行・確認して実行・人に回す」の3段階に分ける設計を勧めています(TypeSafe AI公式ドキュメント「Confidence」)。
デメリット1:文章生成が目的ではなく何でもできるAIではない
1つ目のデメリットとして、Jevは文章を1文字も書かず、画像・音声・動画の入力も非対応です(TypeSafe AI公式ドキュメント「Models」)。
公式FAQも「長い推論が要る課題は推論モデルの方が向く」と認めているので、何でも任せられるAIとして期待すると外れます。
デメリット2:判断そのものは間違えることがある
2つ目のデメリットは判断の間違いで、公式FAQは「Jevが保証するのは答えの形であって、すべての判断が正しいことではない」とはっきり書いています(TypeSafe AI公式FAQ)。
しかも日本語については「英語が主な学習言語で、日本語を含む他言語は同等ではない」と公式が明記しているので、日本語の業務で使うなら自分のデータで試す工程が欠かせません。
デメリット3:Early Access段階で第三者検証がまだ少ない
3つ目のデメリットは提供状況で、2026年9月19日時点のEarly Accessでは、料金・レート制限・提供状況が「予告なく変わる」と公式が書いています。
第三者の検証も前の章で挙げた数件にとどまるため、TypeSafe自身のベンチマークと第三者の評価を分けて読む姿勢が要ります。
りょうたデメリットの2つ目、「形は保証するが判断は間違える」を読んで、僕は逆に信用できると感じました。できないことを公式が先に書いてくれるAIは、業務に組み込むときに設計しやすいんです。
Jevは本当にハルシネーションしない?形式の保証と判断の正しさは別
Jevが「ハルシネーションしない」と言えるのは答えの形式についてであって、判断の内容が100%正しい、との意味ではありません。
公式サイトには「Zero Hallucinations」の表現があり、公式ブログも「can’t hallucinate(ハルシネーションできない)」と書いています(TypeSafe AI公式サイト)。
この言葉を正しく受け取るために、あなたに2つの層を分けて見てほしいんです。
「ハルシネーションしない」が指しているのは答えの形
ChatGPTやClaudeのようなLLMは自由な文章を生成するので、存在しない事実や、指示にない形式の答えを作ってしまうことがあります。
一方でJevは、答えの候補と形をあらかじめ定義しておき、その外側の値を返せない設計です。
公式は「型(type-safe)は数学的に保証される」「この0%は実測ではなく、スキーマの一致が保証されているから」と説明しています(TypeSafe AI公式ブログ)。
つまり「用意した選択肢の外を勝手に作らない」の意味では、たしかにハルシネーションが起きないんですね。
公式FAQは「判断を間違えることはある」と答えている
では判断は本当に常に正しいのかといえば、公式FAQ「Can Jev Still Get Things Wrong?」の答えは「Yes」です(TypeSafe AI公式FAQ)。
公式FAQは「カテゴリの一覧を渡せば一覧の外は選べないが、一覧の中の間違ったものを選ぶことはある」と具体的に書いていて、だからこそ確率とconfidenceでしきい値を決めるよう案内しています。
さらに公式ドキュメントは、確率の当たり具合(較正)は多数の予測の集まりについての性質で、1つの答えの正しさを保証しないとも注記しています(TypeSafe AI公式ドキュメント「System One」)。
公式が公開している9つの苦手なこと
TypeSafeは、現行モデルjev-1.13の苦手なことを9つ、公式ドキュメントで公開しています(TypeSafe AI公式ドキュメント「Jev 1.13 jaggedness」・最終確認2026年9月17日)。
| 苦手なこと | 公式が勧める対処 |
|---|---|
| 質問を字義どおりに読む(意図を汲まない) | 条件をそのまま言葉にする |
| 計算・数え上げ | 計算はコード側でやる |
| 日付・時刻の前後比較 | 部品を取り出してコードで比べる |
| 間接的で多段の推論 | 段数を減らして関係する情報を名指しする |
| 関係ない情報が多い入力 | 先に絞ってから渡す |
| 入力に仕込まれた指示(敵対的な内容) | 基準を明確にして本番前に試す |
| 指示と基準の矛盾 | 指示と基準をそろえる |
| 構造的な整合性の保証 | 1つの判断は1通りの聞き方で聞く |
| 文章生成 | 生成用のモデルを使う |
※公式ドキュメントの表をもとに要約。
このリストを見れば、Jevは「用意された選択肢の中で常識的な判断をする道具」であって、何でも正しく答える魔法ではないと分かりますよね。
りょうた「ハルシネーションしない=間違えない」ではない、これがこの記事でいちばん伝えたい点です。僕自身、公式FAQのYesを見るまでは混同していました。
Jevはどんな人に向いている?向いていない使い方も正直に
Jevが向いているのは、業務の中で「判断」を大量に自動化したい人で、会話や執筆をしたいだけの人には向いていません。
ここまで読んだあなたなら、自分がどちら側かはもう見えているはずです。
いまの時点で関係が深いのは、次の4タイプの人ですよ。
向いているのは業務の中で「判断」を大量に自動化したい人
現時点でJevが関係の深い人
- AIを業務システムに組み込みたい人(問い合わせの振り分け・審査の一次判定)
- AIエージェントを開発している人(次の処理の選択・危険な操作の検出)
- 大量の分類や判定を自動化したい人(記事・投稿・レビューの仕分け)
- LLM APIで判断させている処理の速度とコストを下げたい開発者
公式FAQも「常識的な判断(分類・振り分け・スコアリング・評価)向け」と用途をはっきり限定しています(TypeSafe AI公式FAQ)。
逆に言えば、あなたの仕事に「毎日同じ基準で仕分けている作業」がないなら、いま急いで触る必要はありませんよ。
会話・記事執筆・画像生成・コード生成だけならJev単体では合わない
ChatGPTの代わりに会話したい・ブログ記事を書いてほしい・画像を作りたい・コードを丸ごと書いてほしい、といった目的だけなら、Jev単体の主用途とは違います。
Jevは文章を書かず、画像も扱わないので、これらの用途では最初からClaudeやChatGPTを使う方が早いです。
AIそのものにこれから慣れる段階の人は、AI初心者が挫折しない勉強法|未経験から始める5ステップで土台を作ってから戻ってくる方が、Jevの位置づけも理解しやすくなります。
りょうた僕はブログ運営者なので「執筆はClaude、仕分けはJev候補」と役割で線を引いています。あなたの仕事も、作る作業と仕分ける作業に分けてみると、Jevが要るかどうかが見えますよ。
Jevについてよくある質問
最後に、Jevについてよくある質問にお答えします。
まとめ:Jevは文章生成ではなく「判断」に特化したAI
今回は、Jevとは何かを、ChatGPT・Claudeとの違い・料金・使い方まで公式情報で解説しました。
最後にポイントを振り返ります。
- JevはTypeSafe AIが2026年9月15日に発表した初のSystem One Modelで、文章を書かずに分類・評価・判断の答えを確率つきで返す
- 判断方法はNoul・Choice・Scoreの3つで、答えには確率とconfidenceが付き、人の確認が要る判断を分けられる
- 料金は入力100万トークン0.042ドル・出力無料で、TypeSafe直利用はEarly Access(waitlist制)。常設の無料プランは未確認で、無料クレジットは規約上「裁量で付与する場合がある」にとどまる
- 193.6倍・444.6倍はTypeSafe自身のワークフロー評価で、第三者検証では速さと安さは確認されつつ精度は用途次第
- 「ハルシネーションしない」は答えの形式の話で、判断そのものは間違えるため、confidenceで運用を設計する
JevはChatGPTやClaudeを置き換えるAIではなく、ソフトウェアやAIワークフローの中で高速に「判断」を担当するAIです。
まだ登場から日が浅いので、料金や提供状況は公式サイトで最新の内容を確かめてから判断してください。
Claude側の準備がまだの人は、Claudeの始め方|登録から初期設定・活用法まで初心者向けに全解説から「作る係」を先に整えておくと、Jevの出番が見えやすくなりますよ。
りょうた新しいAIの名前を見るたびに全部試す必要はありません。Jevは「作る」ではなく「仕分ける」の道具だと分かっていれば、必要になった日に迷わず手を伸ばせます。